togatoga / karukan
← 返回首页
Japanese Input Method System for Linux, macOS, Neural Kana-Kanji Conversion Engine
📄 仓库 README
在 GitHub 查看 ↗来自 GitHub 仓库自述文件 · 版权归原作者所有
Karukan
Linux・macOS向け日本語入力システム — ニューラルかな漢字変換エンジン
[](https://github.com/togatoga/karukan/actions/workflows/karukan-engine-ci.yml) [](https://github.com/togatoga/karukan/actions/workflows/karukan-im-ci.yml) [](https://github.com/togatoga/karukan/actions/workflows/karukan-fcitx5-ci.yml) [](https://github.com/togatoga/karukan/actions/workflows/karukan-macos-ci.yml) [](LICENSE-MIT)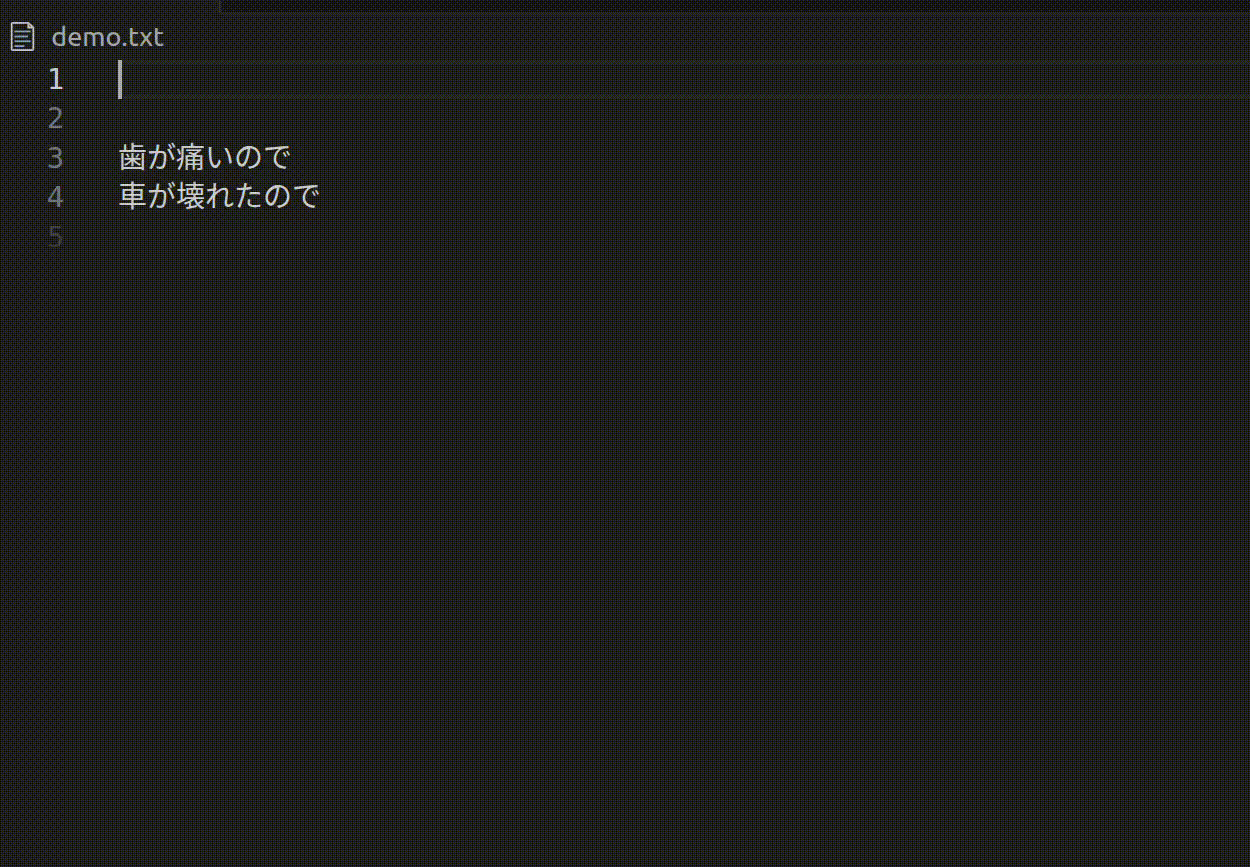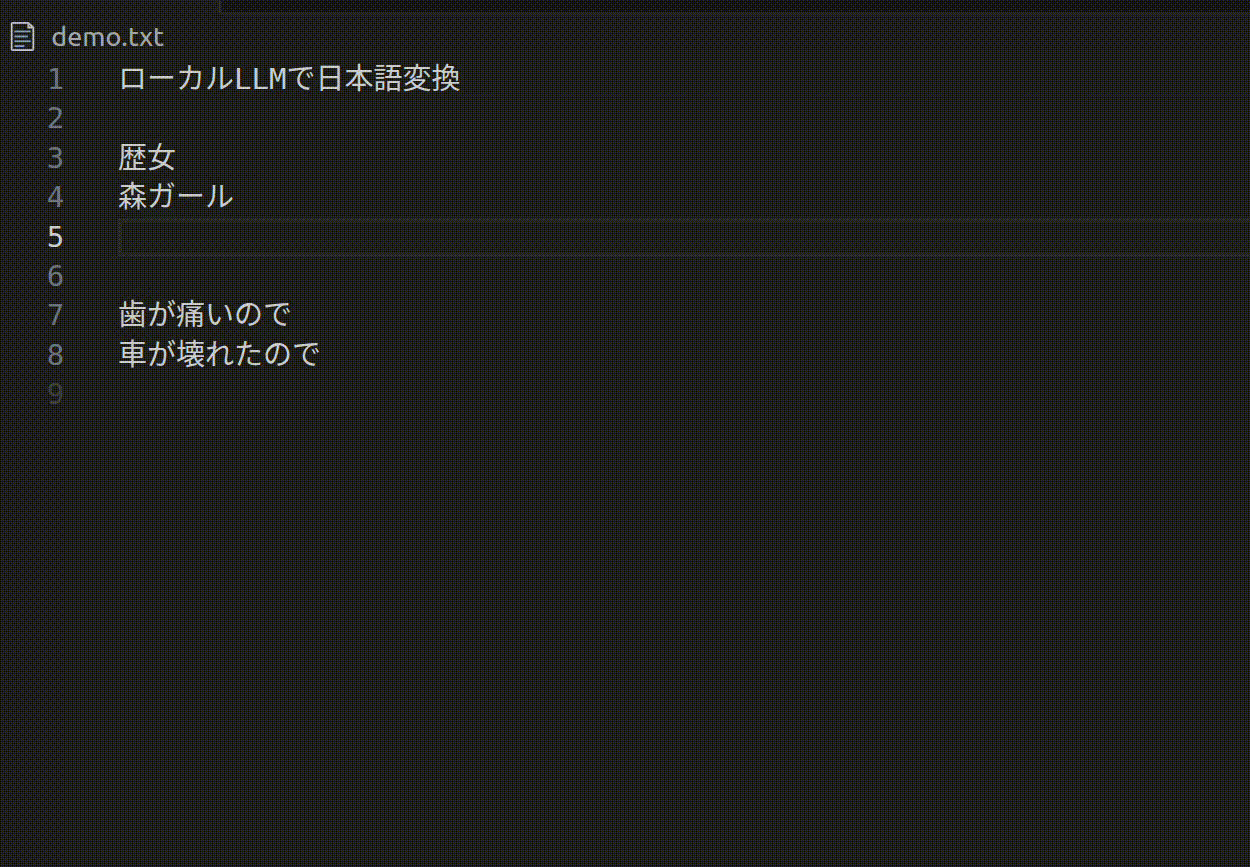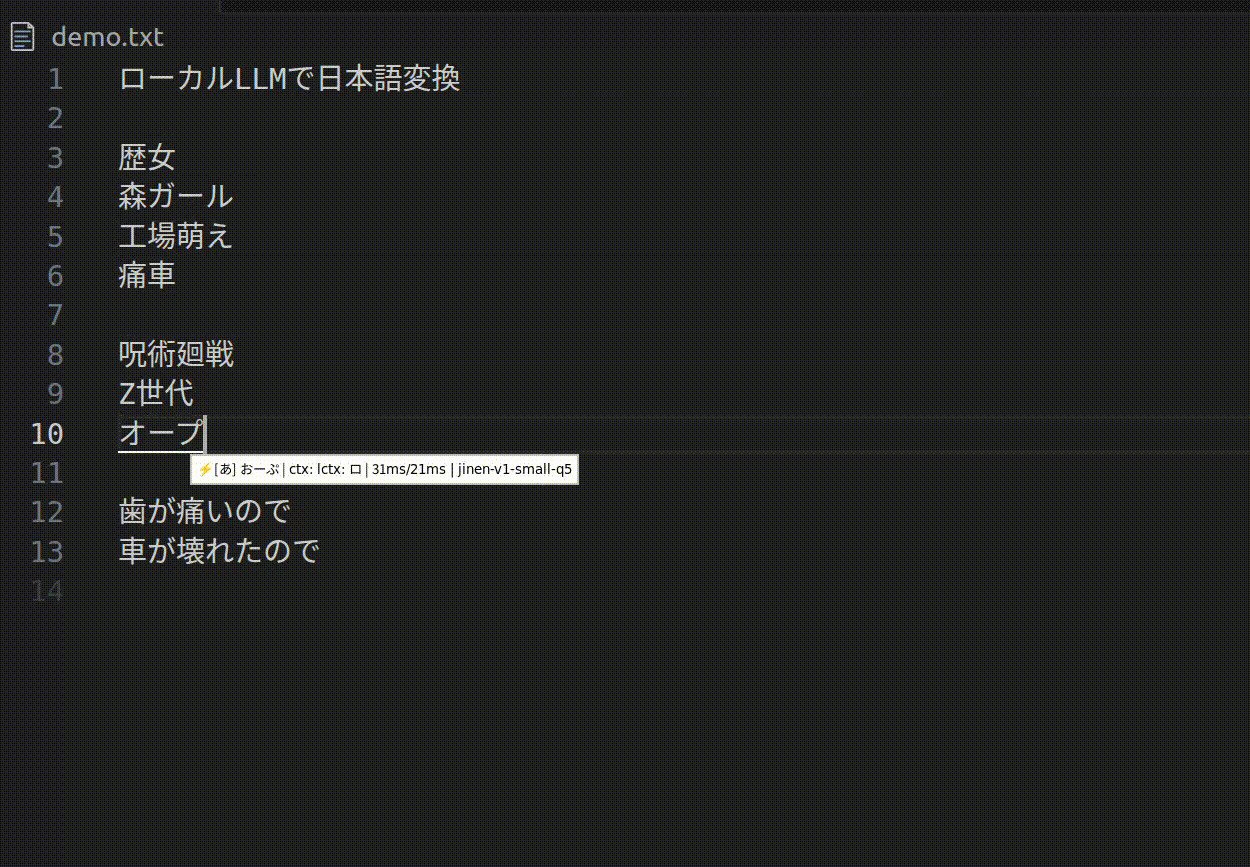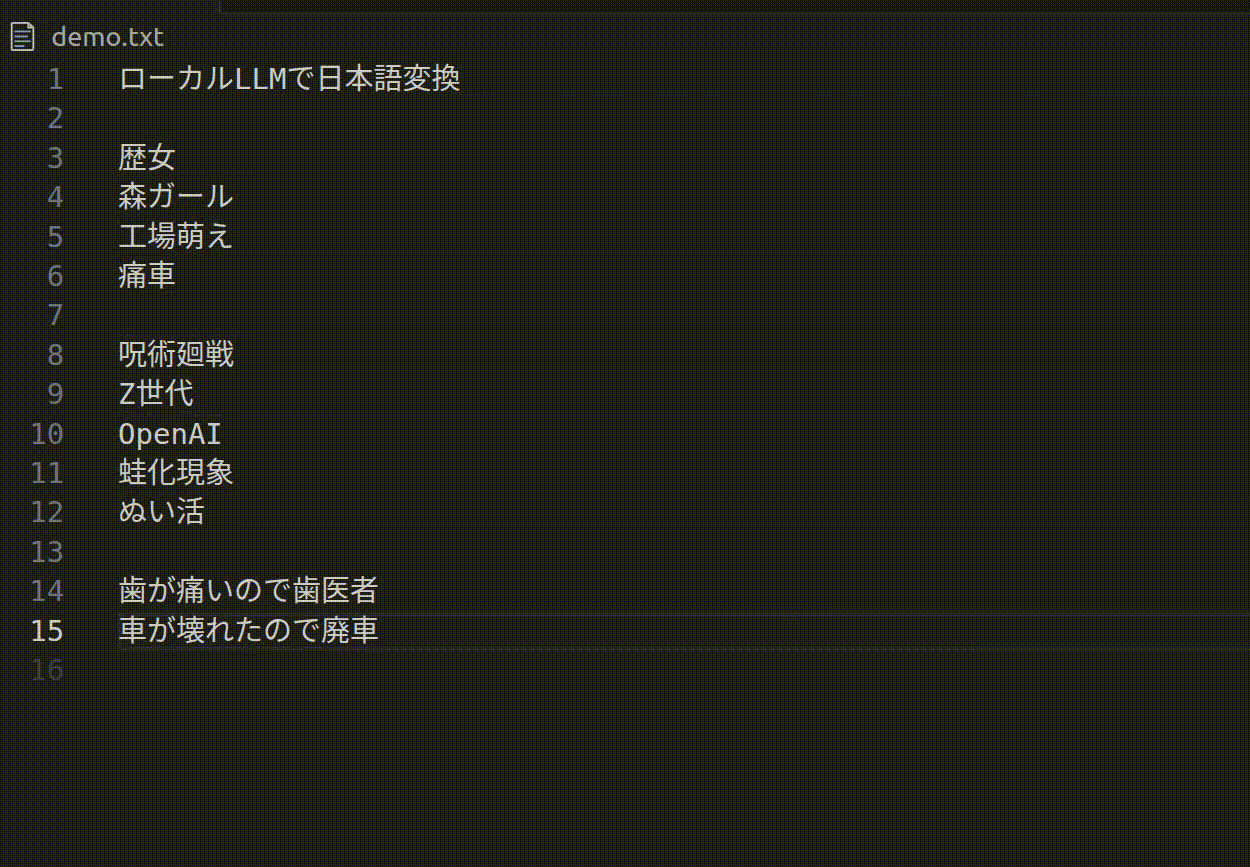
プロジェクト構成
IME本体(コアエンジン + 各プラットフォームのフロントエンド)は karukan-im/ 配下にまとまっています。
- karukan-im/ — IME本体
- core/ — 共有IMEエンジン(crate:
karukan-im) — ステートマシン、ローマ字変換、karukan-imserver(macOS向けJSON-RPCサーバー) - fcitx5/ — Linux向けフロントエンド(crate:
karukan-fcitx5) — fcitx5アドオン + C FFI - macos/ — macOS向けフロントエンド — Swift/InputMethodKit
- karukan-engine/ — コアライブラリ — ローマ字→ひらがな変換 + llama.cppによるニューラルかな漢字変換
- karukan-cli/ — CLIツール・サーバー — 辞書ビルド、Sudachi辞書生成、辞書ビューア、AJIMEE-Bench、HTTPサーバー
特徴
- ニューラルかな漢字変換: GPT-2/Qwen3ベースのモデルをllama.cppで推論し、高度な日本語変換
- ライブ変換: 入力と同時に変換結果をリアルタイム表示。Spaceを押さずに変換が進む(
Ctrl+Shift+LでON/OFF) - コンテキスト対応: 周辺テキストを考慮した日本語変換
- 変換学習: ユーザーが選択した変換結果を記憶し、次回以降の変換で優先表示。予測変換(前方一致)にも対応し、入力途中でも学習済みの候補を提示
- システム辞書: SudachiDictの辞書データからシステム辞書を構築
- 候補リライター (Mozcから移植): 半角カタカナ、英字の大文字小文字・全角半角、記号の関連候補、数字の各種表記(漢数字・大字・ローマ数字・丸数字・16/8/2進数)を自動生成。各候補にはMozc由来の注釈(「半角カタカナ」「16進数」など)が付く
- 単漢字変換: 読み全体を漢字1文字ずつ候補にする(「たか」→ 高・嵩・鷹など)。モデルや辞書が出さない字を候補一覧の後方から拾える。旧字体・異体字には「高の異体字」のような注釈付き(単漢字変換 参照)
- 絵文字入力: かな読み(
ぴえん→ 🥺、きんにく→ 💪)と Slack 風:triggerクエリ(:smile→ 😄、:halo→ 😇)の両方をサポート - 変換ペルソナ: よく書く文章と関連のあるキーワードを config.toml に書くと、それに寄せた変換が出やすくなる(変換ペルソナ 参照)
Note: 初回起動時にHugging Faceからモデルをバックグラウンドでダウンロードします。ダウンロード中もかな入力と辞書変換はそのまま使え、モデルの読み込みが完了すると自動でニューラル変換が有効になります。ネットワークを使うのはこの初回ダウンロードだけで、2回目以降はダウンロード済みのモデルが使われます。
インストール
- Linux (fcitx5): karukan-fcitx5 の README を参照
- macOS: karukan-macos の README を参照
ドキュメント
- キーバインド一覧 — 共通キーバインドと Linux / macOS 固有キー
- 設定 — config.toml の設定項目、ライブ変換、変換ストラテジー、学習キャッシュ
- 辞書 — システム辞書のインストール、ユーザー辞書、候補の優先順位
- ユーザー辞書 — 対応形式(Mozc/Google IME TSV・バイナリ)と登録方法
- 変換ペルソナ — よく書く文章と関連のあるキーワードを書いて、変換をそれに寄せる方法
- Chunk — 変換が Chunk に区切られる場所と、自分で区切って表示を固定する方法
- 記号・半角全角 — 句読点や括弧の種類、記号・数字・英字の幅、スペースの設定
- 単漢字変換 — 読みを漢字1文字ずつに変換する候補と、そのデータの編集方法
ライセンス
MIT OR Apache-2.0 のデュアルライセンスで提供しています。
karukan-engine/data/ 配下には Mozc から派生したデータを含み、こちらは BSD 3-Clause License のもとで配布されています。各派生ファイルの由来およびMozcの著作権表記は THIRD_PARTY_LICENSES を参照してください。
📈 近 7 天 Star 趋势
每日新增 Star(柱)与累计 Star(线)· 数据来自 GitHub
🏆 排名变化趋势
在各榜单中的排名历史(数字越小越靠前)
📋 历史上榜记录
每次快照的详细数据
| 日期 | 榜单 | 排名 | 周期新增 | 总 STAR |
|---|