📄 仓库 README
在 GitHub 查看 ↗🔥 MediaCrawler - 自媒体平台爬虫 🕷️
BrowserAct 支持一句话从任意网站提取数据。无需代码,一次构建、稳定复用,Token 消耗极低。BrowserAct 使用真实浏览器自动构建数据采集 Bot,内置隐身浏览、验证码处理和住宅代理,直接输出结构化结果。立即免费试用。
免责声明:
大家请以学习为目的使用本仓库⚠️⚠️⚠️⚠️,爬虫违法违规的案件
本仓库的所有内容仅供学习和参考之用,禁止用于商业用途。任何人或组织不得将本仓库的内容用于非法用途或侵犯他人合法权益。本仓库所涉及的爬虫技术仅用于学习和研究,不得用于对其他平台进行大规模爬虫或其他非法行为。对于因使用本仓库内容而引起的任何法律责任,本仓库不承担任何责任。使用本仓库的内容即表示您同意本免责声明的所有条款和条件。
点击查看更为详细的免责声明。点击跳转
📖 项目简介
一个功能强大的多平台自媒体数据采集工具,支持小红书、抖音、快手、B站、微博、贴吧、知乎等主流平台的公开信息抓取。
🔧 技术原理
- 核心技术:基于 Playwright 浏览器自动化框架登录保存登录态
- 无需JS逆向:利用保留登录态的浏览器上下文环境,通过 JS 表达式获取签名参数
- 优势特点:无需逆向复杂的加密算法,大幅降低技术门槛
✨ 功能特性
| 平台 | 关键词搜索 | 指定帖子ID爬取 | 二级评论 | 指定创作者主页 | 登录态缓存 | IP代理池 | 生成评论词云图 |
|---|---|---|---|---|---|---|---|
| 小红书 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 抖音 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 快手 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| B 站 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 微博 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 贴吧 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 知乎 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
🚀 开源版不够用?看看 MediaCrawlerPro 多了什么:断点续爬 · 多账号 + IP 代理池 · 去掉 Playwright · 多个 AI Agent 项目源码(点击展开)
> 专注于学习成熟项目的架构设计,不仅仅是爬虫技术,Pro 版本的代码设计思路同样值得深入学习! [MediaCrawlerPro](https://github.com/MediaCrawlerPro) 相较于开源版本的核心优势: #### 🎯 核心功能升级 - ✅ **断点续爬功能**(重点特性) - ✅ **多账号 + IP代理池支持**(重点特性) - ✅ **去除 Playwright 依赖**,使用更简单 - ✅ **完整 Linux 环境支持** #### 🏗️ 架构设计优化 - ✅ **代码重构优化**,更易读易维护(解耦 JS 签名逻辑) - ✅ **企业级代码质量**,适合构建大型爬虫项目 - ✅ **完美架构设计**,高扩展性,源码学习价值更大 #### 🎁 额外功能 - ✅ **AI Agent Skill 支持**(Codex / [OpenClaw](https://openclaw.ai/) 🦞 / [Hermes](https://github.com/NousResearch/hermes-agent) / Claude Code / [DeepSeek Harness](https://github.com/deepseek-ai/deepseek-harness) / [cc-haha](https://github.com/NanmiCoder/cc-haha) / WorkBuddy / 豆包 / Trae / Qoder / Cursor 一键安装,让 Agent 自动爬取数据) - ✅ **评论分析 Agent**(🆕 新上线):输入关键词或链接,自动采集评论并生成研究报告 - ✅ **自媒体内容拆解 Agent**:解析内容、视频转文字、拆解爆款元素 - ✅ **多平台首页信息流推荐**(HomeFeed)和**热搜榜单** - ✅ **自媒体视频下载器桌面端**(适合学习全栈开发) - ✅ **AI 图片生成 Agent**:多轮迭代自动优化,内置精选模板库 开源不易,欢迎订阅支持!点击查看:[MediaCrawlerPro 项目主页](https://github.com/MediaCrawlerPro) 更多介绍
🚀 快速开始
💡 如果这个项目对您有帮助,请给个 ⭐ Star 支持一下!
📋 前置依赖
🚀 uv 安装(推荐)
在进行下一步操作之前,请确保电脑上已经安装了 uv:
- 安装地址:uv 官方安装指南
- 验证安装:终端输入命令
uv --version,如果正常显示版本号,证明已经安装成功 - 推荐理由:uv 是目前最强的 Python 包管理工具,速度快、依赖解析准确
🟢 Node.js 安装
项目依赖 Node.js,请前往官网下载安装:
- 下载地址:https://nodejs.org/en/download/
- 版本要求:>= 16.0.0
📦 Python 包安装
# 进入项目目录
cd MediaCrawler

# 使用 uv sync 命令来保证 python 版本和相关依赖包的一致性
uv sync
🌐 浏览器驱动安装(可选)
如果使用默认的 CDP 模式(连接已有 Chrome 浏览器),无需安装浏览器驱动。仅在使用标准 Playwright 模式时需要安装。
# 仅在标准 Playwright 模式下需要安装浏览器驱动
uv run playwright install
🌍 Chrome 浏览器配置(推荐)
项目默认使用 CDP 模式连接用户已有的 Chrome 浏览器,可以复用浏览器已有的登录状态、Cookie、扩展等,大幅降低平台风控检测风险。
使用前需要:
- 安装最新版 Chrome 浏览器(版本 >= 144),下载地址
- 开启远程调试功能:在 Chrome 地址栏输入
chrome://inspect/#remote-debugging,勾选 "Allow remote debugging for this browser instance" - 页面显示
Server running at: 127.0.0.1:9222表示已就绪
💡 提示:运行爬虫后,Chrome 浏览器会弹出确认对话框,点击"接受"即可。程序会等待用户确认,60秒内操作完成即可。
如果不想使用 CDP 模式,可以在
config/base_config.py中设置ENABLE_CDP_MODE = False切换为标准 Playwright 模式。
🚀 运行爬虫程序
# 在 config/base_config.py 查看配置项目功能,写的有中文注释

# 从配置文件中读取关键词搜索相关的帖子并爬取帖子信息与评论
uv run main.py --platform xhs --lt qrcode --type search

# 从配置文件中读取指定的帖子ID列表获取指定帖子的信息与评论信息
uv run main.py --platform xhs --lt qrcode --type detail

# 打开对应APP扫二维码登录

# 其他平台爬虫使用示例,执行下面的命令查看
uv run main.py --help
📥 媒体下载(封面 / 视频 / 图文图片)
默认关闭。开启后会在爬取的同时把媒体文件下载到本地,按帖子聚合存放:# 命令行开关
uv run main.py --platform xhs --type detail --specified_id <帖子URL或ID> --get_media true
# 或在 config/base_config.py 中设置 ENABLE_GET_MEDIA = True
data/xhs/media/{帖子ID}/
├── cover.jpg     # 封面
├── video.mp4     # 视频(B站为 DASH 合流产物)
└── 001.jpg       # 图文帖的图片
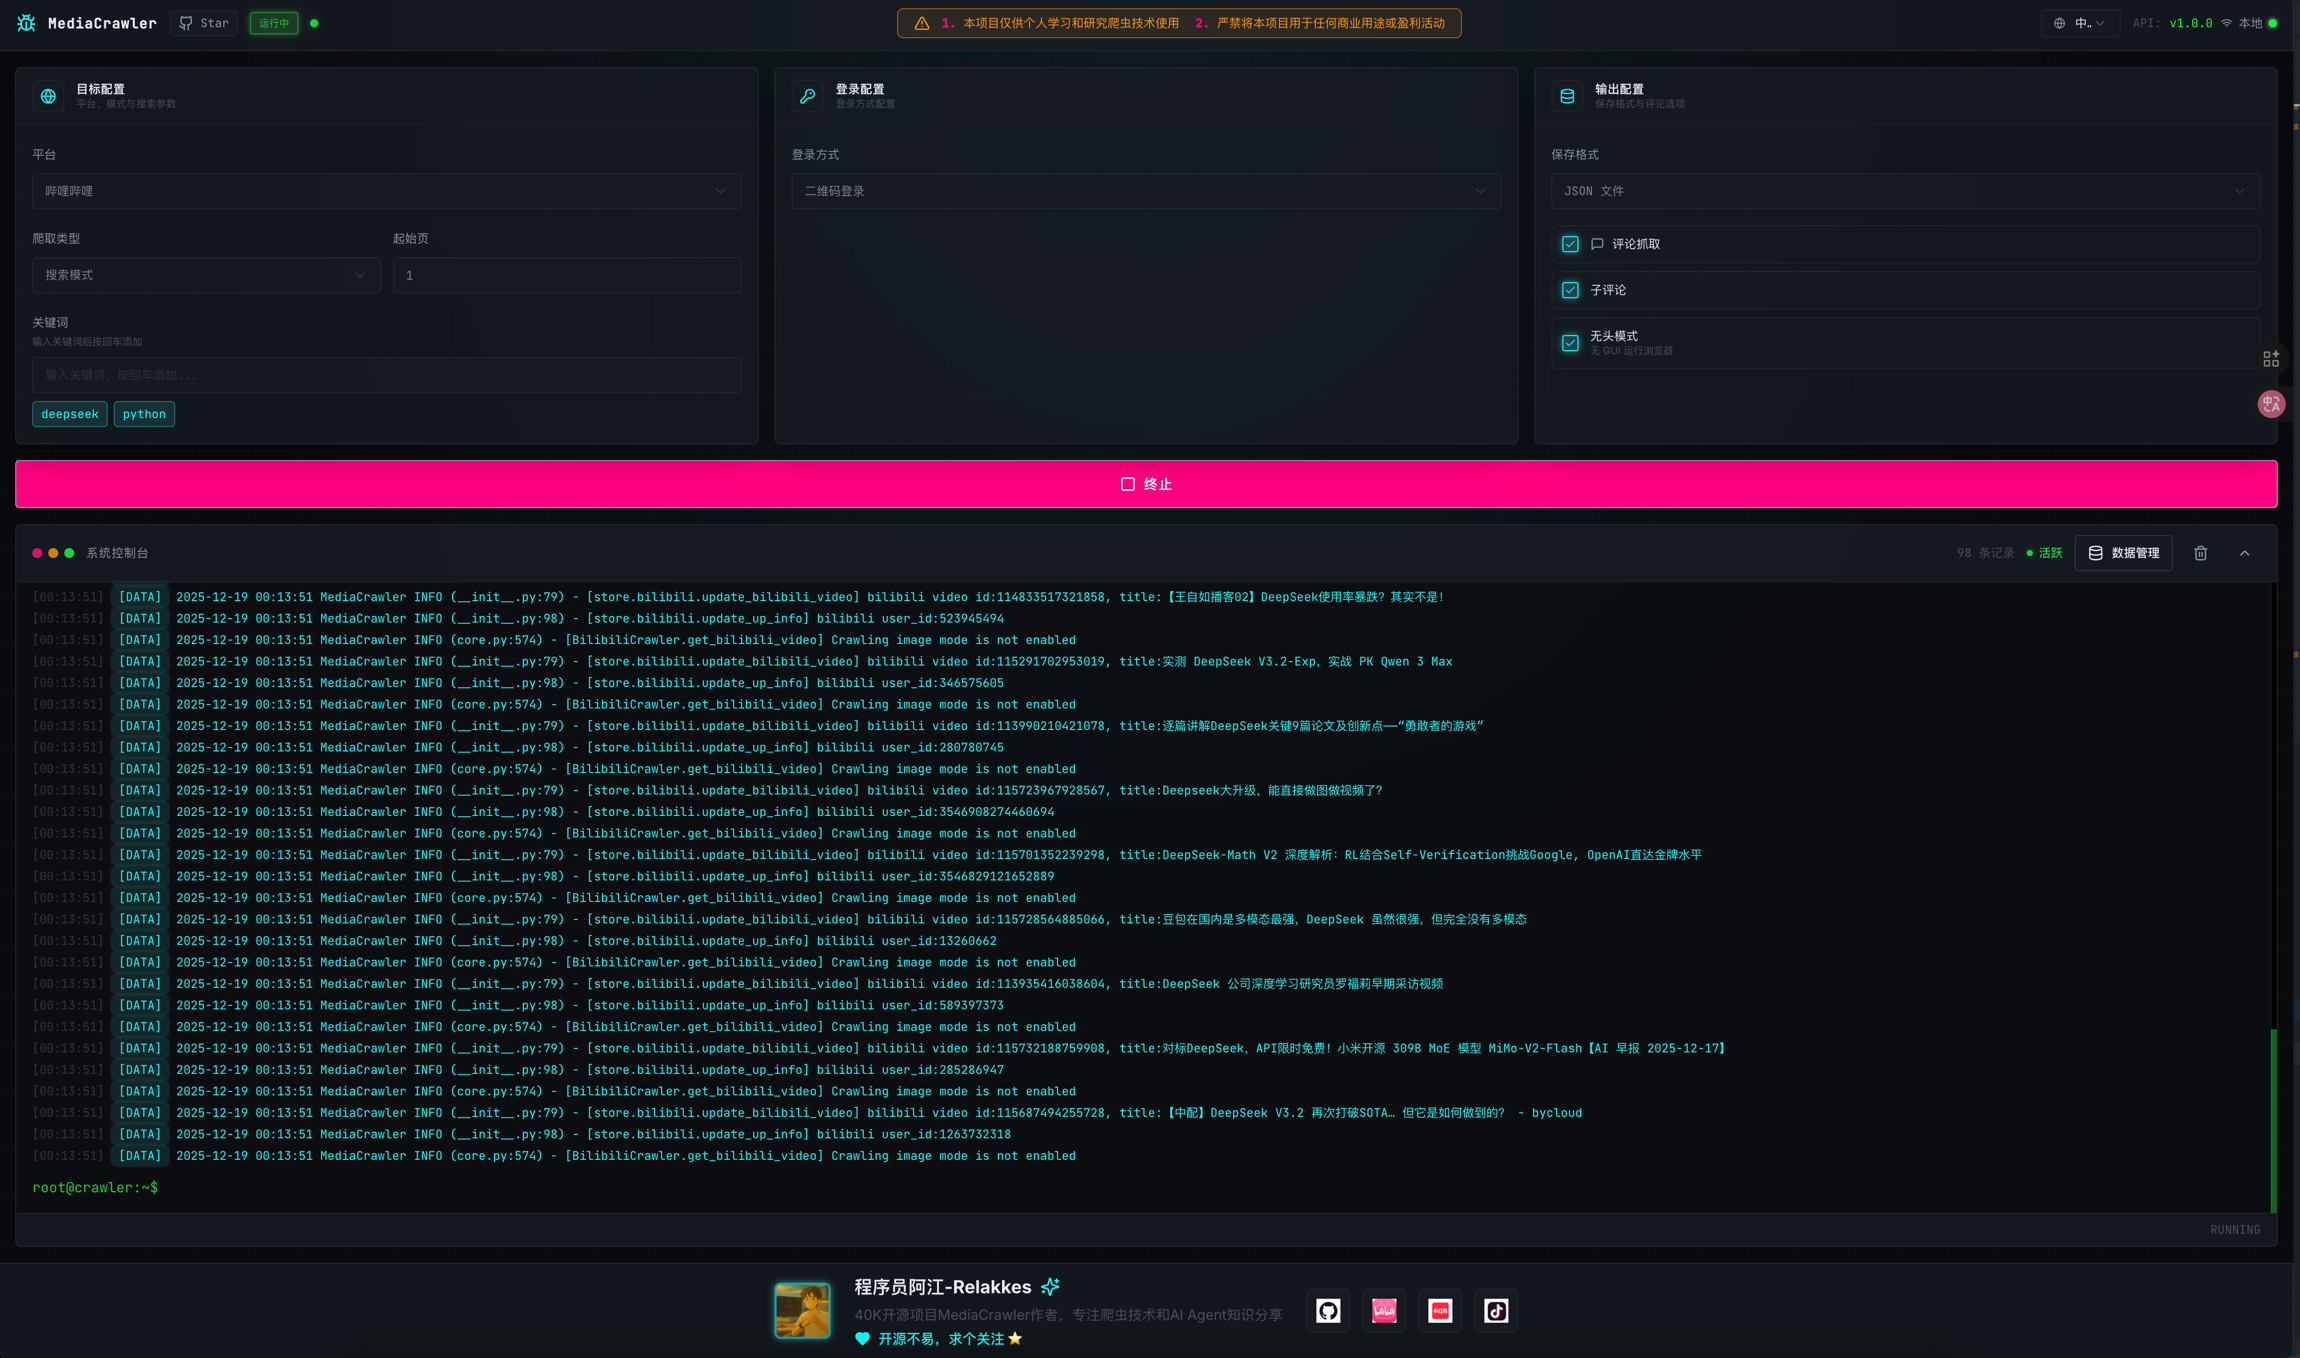
🖥️ WebUI 可视化操作界面
MediaCrawler 提供了基于 Web 的可视化操作界面,无需命令行也能轻松使用爬虫功能。 #### 开发调试(推荐) 开发时需要同时启动后端 API 服务和前端 Vite 开发服务器:# 终端 1:启动 API 服务器(默认端口 8080)
uv run uvicorn api.main:app --port 8080 --reload
# 终端 2:启动前端开发服务器
cd webui
npm install
npm run dev # 默认在 5173 端口启动,并代理 /api 到 8080
cd webui
npm install
npm run build      # 产物输出到 api/webui/
uv run uvicorn api.main:app --port 8080 --reload
🔗 使用 Python 原生 venv 管理环境(不推荐)
#### 创建并激活 Python 虚拟环境 > 如果是爬取抖音和知乎,需要提前安装 nodejs 环境,版本大于等于:`16` 即可# 进入项目根目录
cd MediaCrawler
# 创建虚拟环境
# 我的 python 版本是:3.11 requirements.txt 中的库是基于这个版本的
# 如果是其他 python 版本,可能 requirements.txt 中的库不兼容,需自行解决
python -m venv venv
# macOS & Linux 激活虚拟环境
source venv/bin/activate
# Windows 激活虚拟环境
venv\Scripts\activate
pip install -r requirements.txt
playwright install
# 项目默认是没有开启评论爬取模式,如需评论请在 config/base_config.py 中的 ENABLE_GET_COMMENTS 变量修改
# 一些其他支持项,也可以在 config/base_config.py 查看功能,写的有中文注释

# 从配置文件中读取关键词搜索相关的帖子并爬取帖子信息与评论
python main.py --platform xhs --lt qrcode --type search

# 从配置文件中读取指定的帖子ID列表获取指定帖子的信息与评论信息
python main.py --platform xhs --lt qrcode --type detail

# 打开对应APP扫二维码登录

# 其他平台爬虫使用示例,执行下面的命令查看
python main.py --help
💾 数据保存
MediaCrawler 支持多种数据存储方式,包括 CSV、JSON、JSONL、Excel、SQLite 和 MySQL 数据库。
📖 详细使用说明请查看:数据存储指南
🚀 MediaCrawlerPro 重磅发布 🚀!更多的功能,更好的架构设计!开源不易,欢迎订阅支持!
💬 交流群组
💰 赞助商展示
| 赞助商 | 介绍 |
|---|---|
|
TikHub.io 提供 900+ 高稳定性数据接口,覆盖 TK、DY、XHS、Y2B、Ins、X 等 14+ 海内外主流平台,支持用户、内容、商品、评论等多维度公开数据 API,并配套 4000 万+ 已清洗结构化数据集,使用邀请码 cfzyejV9 注册并充值,即可额外获得 $2 赠送额度。
|
|
NodeMaven 是面向网页抓取和自动化场景的高效代理服务商,提供市面上最高质量的 IP。主要优势包括 99.9% 可用性、ZIP 邮编定位、IP 过滤(所有代理的欺诈评分均低于 97%)、无需 KYC,以及代理带宽检测器、Meta 标签检测器、IP 查询等独家免费工具。MediaCrawler 用户使用优惠码 CRAWLER35 可享移动和住宅代理 35% 折扣,使用 CRAWLER40 可享 ISP(静态)代理 40% 折扣。👉 访问 NodeMaven
|
|
感谢 OpenLux 对本项目的赞助!OpenLux 是一个面向企业的一站式 AI 聚合平台,汇集全球各大厂商主流大模型,平台提供高效、稳定的服务与及时的技术支持。Claude、OpenAI、Gemini 系列模型基准折扣分别低至官方的 0.882 折、0.4 折和 0.8 折。MediaCrawler 用户还可享受专属福利:通过专属链接注册,充值最高可享 7.5% 优惠!👉 立即体验 |
|
SX.ORG 是专为高频数据采集与反爬对抗打造的高性能代理网络,完美适配 MediaCrawler 等多平台抓取工具。核心优势包括全球 190+ 地区真实住宅 IP 池、99.9% 稳定连通率、精准国家/城市及 ASN 运营商定位、全面支持 HTTP(S) 与 SOCKS5 协议,以及针对社交媒体风控优化的智能会话轮换。MediaCrawler 用户使用专属优惠码 CRAWLER3G 注册即可免费领取 3GB 优质测试流量。👉 访问 SX.ORG 领取 3GB 流量
|
|
ProxyLane 提供中国住宅 IP(电信、联通、移动),适合在海外服务器运行 MediaCrawler,出口可固定到上海、北京、广州、深圳等城市。在 static 模式的代理用户名后加 _c_CN_city_Shanghai 即可使用上海住宅 IP,完整配置见 3 步接入指南。MediaCrawler 用户使用优惠码 MEDIACRAWLER3GB 注册即可免费领取 3GB 流量。👉 免费领取 3GB
|
|
Proxy-Seller 是面向网页抓取、数据采集与自动化场景的专业代理服务商,提供住宅、移动(4G/5G/LTE)、静态 ISP、数据中心 IPv4 与 IPv6 五大产品线,覆盖全球 220+ 地区,拥有 4700 万+ 住宅 IP 资源,可精准定位国家、城市及运营商(ISP)。主要优势包括 99.7% 可用性、全面支持 HTTP(S) 与 SOCKS5 协议、静态/轮换 IP 灵活切换、高并发请求支持,以及提供 RESTful API 与多语言 SDK(Python、Node.js、PHP、Java、Go),并配备 24/7 技术支持。服务通过 ISO/IEC 27001 与 ISO 9001 认证,全球用户已超 18.5 万,适合 MediaCrawler 等多平台抓取工具使用。MediaCrawler 用户使用优惠码 MCRAWLER15 可享 15% 折扣。👉 访问 Proxy-Seller
|
|
感谢 DragTokens(Drag API) 对本项目的赞助!DragTokens 专注于为开发者提供多模型 API 中转服务,支持 Claude Code、Codex、Gemini CLI 等 AI 编程工具,覆盖 GPT、Claude、Gemini 等主流模型。Claude 官方客户端专用分组倍率低至 1.1×(对比官方 API 约 1.55 折,节省约 84.5%)、Codex 倍率低至 0.3×(约 0.42 折,节省约 96%)、Gemini 倍率低至 0.25×(约 0.35 折,节省约 96.5%),号池峰值 TPM 达 7 亿。 🎁 通过 专属链接注册的新用户即送赠金,单次充值满 100 元还可享受 10% 返现!配套新手入门、工具配置及 API 示例文档,接入有教程,使用有指引。不存储您的提示词与模型回复,并为企业及高校团队提供专属账户池、对公转账与开票支持。 |
🤝 成为赞助者
成为赞助者,可以将您的产品展示在这里,每天获得大量曝光!
联系方式:
- 微信:relakkes
- 邮箱:relakkes@gmail.com
☕ 请作者喝杯咖啡
如果这个项目对您有帮助,欢迎打赏支持,您的每一份支持都是我持续更新的动力 ❤️
 微信赞赏 |
 支付宝 |
Buy Me a Coffee |
📚 其他
- 常见问题:MediaCrawler 完整文档
🧩 我的其他项目
- 正在创业做的项目:ModelDial — 在私有数据集上实测 AI 模型,对比能力、费用和思考档位,帮你找到适合自己任务的模型
- 开源桌面端 Agent:cc-haha — 本地优先、跨平台的 Agent 桌面工作台,支持多 Agent 协作、Git Worktree、技能市场、多模型与 Computer Use,并可通过微信 / 飞书 / 钉钉等远程接入
- DeepSeek Harness 插件:dsh-agent-teams — 给 DeepSeek Harness 装上 Agent Teams,让多个 Agent 组队并行协作完成复杂任务
⭐ Star 趋势图
如果这个项目对您有帮助,请给个 ⭐ Star 支持一下,让更多的人看到 MediaCrawler!
📚 参考
- 小红书签名仓库:Cloxl 的 xhs 签名仓库
- 小红书客户端:ReaJason 的 xhs 仓库
- 短信转发:SmsForwarder 参考仓库
- 内网穿透工具:ngrok 官方文档
免责声明
📈 近 7 天 Star 趋势
🏆 排名变化趋势
📋 历史上榜记录
| 日期 | 榜单 | 排名 | 周期新增 | 总 STAR |
|---|